Business Analysis with llm, mcp and data warehouse
Build một MCP server giờ đây rất dễ — có chút kiến thức lập trình cộng với sự hướng dẫn của AI là xong trong một buổi chiều. Nhưng khoảng cách từ "chạy được" đến "dám cho cả tổ chức dùng trên dữ liệu thật" lại là một câu chuyện hoàn toàn khác. Bài viết này chia sẻ giải pháp tôi đã xây dựng cho bài toán phân tích dữ liệu doanh nghiệp qua MCP: những gì đã làm được — whitelist dữ liệu, OAuth 2.1 với introspection/revocation, shared cache cho thu hồi quyền tức thì — và những thách thức vẫn còn ở phía trước.
Bài toán
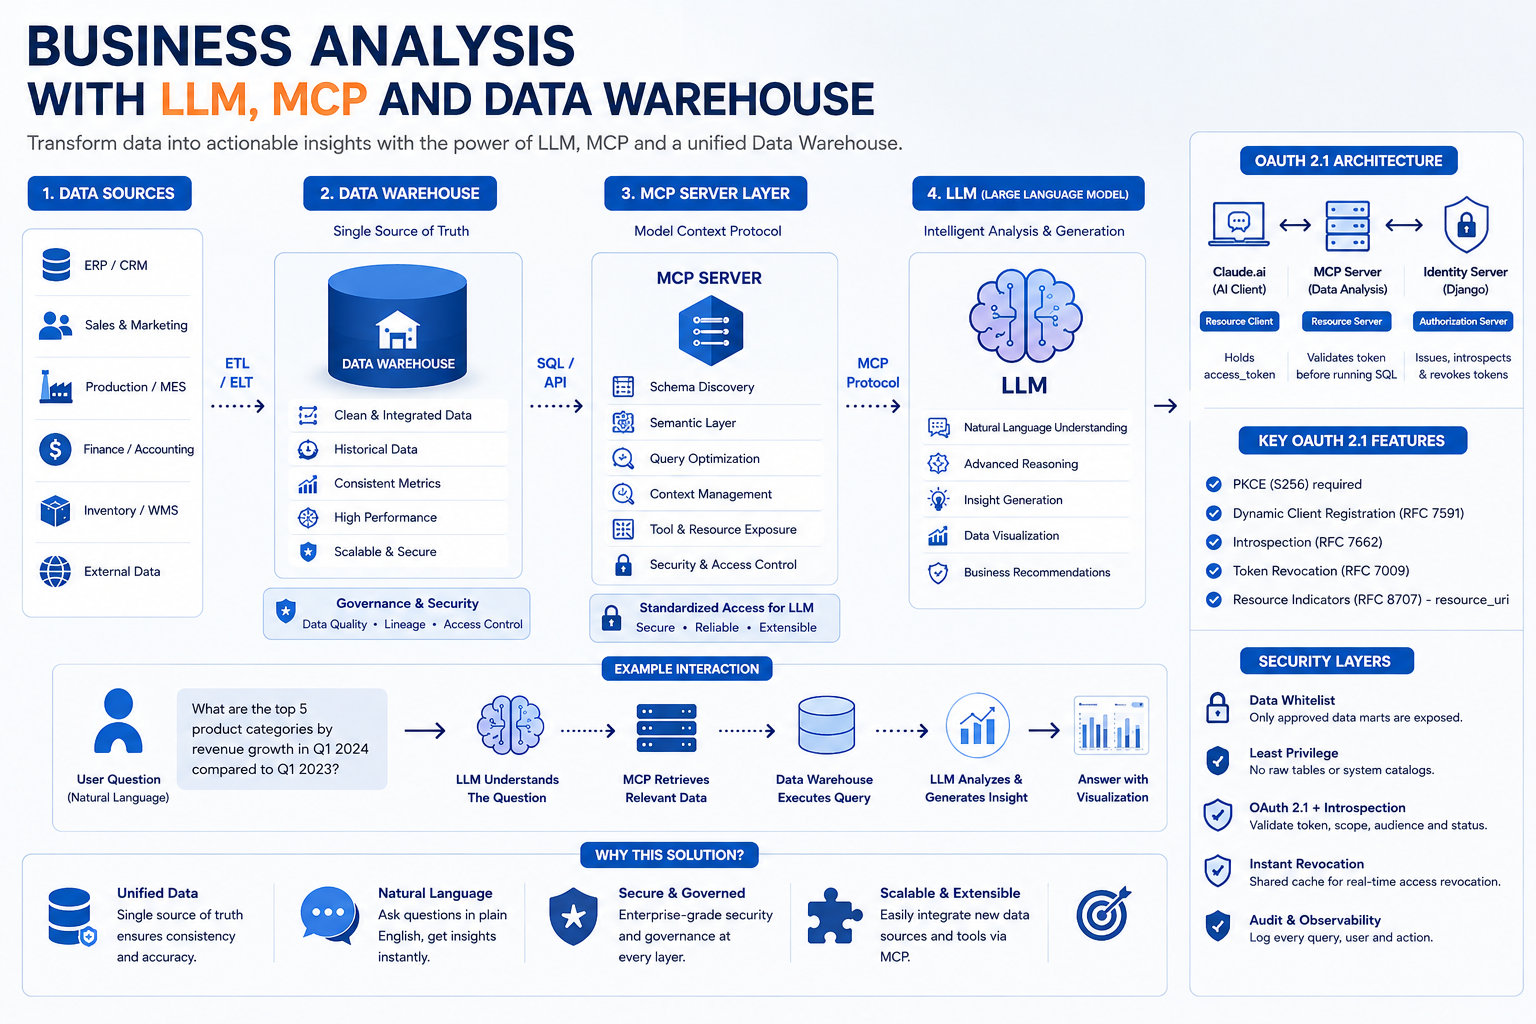
Doanh nghiệp nào cũng có một Data Warehouse (DWH) — nơi lưu trữ toàn bộ hoạt động: doanh thu, khách hàng, tài chính, sản xuất, KPI. Khi Model Context Protocol (MCP) xuất hiện, việc cho AI như Claude truy vấn trực tiếp DWH để phân tích kinh doanh trở nên rất hấp dẫn: người dùng chỉ cần hỏi bằng ngôn ngữ tự nhiên, AI tự sinh SQL và trả về báo cáo.
Nhưng sức mạnh đó đi kèm rủi ro. Dữ liệu P&L, lương thưởng, giá vốn, hạn mức tín dụng khách hàng — nếu ai trong tổ chức cũng truy vấn được như nhau thì đó là lỗ hổng nghiêm trọng. Tôi cần trả lời ba câu hỏi:
 1. AI được phép thấy những gì trong DWH?
2. Ai đang đứng sau mỗi truy vấn, và họ có quyền không?
3. Khi nhân sự thay đổi, làm sao thu hồi quyền ngay lập tức?
Nói thẳng: viết một MCP server expose tool execute_sql chỉ mất vài giờ — SDK có sẵn, AI viết giúp phần lớn code, demo chạy ngay. Đó không còn là điểm khác biệt. Cái khó, và là toàn bộ phần còn lại của bài này, nằm ở mọi thứ xung quanh cái server đó: kiểm soát dữ liệu được expose, định danh người dùng, thu hồi quyền theo thời gian thực, và vận hành ổn định khi hạ tầng có sự cố. Một MCP server không có những lớp này chỉ nên dừng ở demo.
Lớp phòng thủ đầu tiên: whitelist dữ liệu
Trước khi nói đến xác thực, nguyên tắc least privilege phải áp dụng ngay ở tầng dữ liệu. MCP server của tôi không cho phép truy vấn system catalog hay các bảng giao dịch thô (raw fact tables). Chỉ một danh sách nhỏ các bảng tổng hợp (data mart) đã được kiểm duyệt — doanh thu theo khách hàng, theo sản phẩm, kết quả kinh doanh, KPI — mới được expose.
Mọi câu SQL đi qua một security layer kiểm tra tên bảng trước khi thực thi. Truy vấn all_tables hay bảng ngoài whitelist bị chặn thẳng. Cách này có hai lợi ích: giảm bề mặt tấn công, và buộc đội data phải chủ đích quyết định "dữ liệu nào đủ an toàn cho AI" thay vì mở toang rồi vá sau.
Kiến trúc OAuth 2.1: ba vai, một trust model
Điểm dễ nhầm lẫn nhất khi làm OAuth cho MCP là phân vai. Trong hệ thống của tôi:
Claude.ai (AI client)        →  Resource Client   — giữ access_token
MCP Server (data analysis)   →  Resource Server   — kiểm tra token trước khi chạy SQL
Identity Server (Django)     →  Authorization Server — cấp, introspect, revoke token
Identity server tự xây trên Django, chuẩn OAuth 2.1: PKCE S256 bắt buộc, Dynamic Client Registration (RFC 7591) để Claude.ai tự đăng ký client, và hai endpoint quan trọng nhất của bài này — introspection và revocation.
Model client phân biệt hai loại:
- MCP Client (như Claude.ai): public client, đăng ký động qua DCR, không có secret, bắt buộc PKCE.
- MCP Server: pre-registered, có client secret, và có thêm trường
resource_uri(RFC 8707) — định danh tài nguyên mà server đó bảo vệ.
resource_uri chính là chìa khóa cho trust model ở phần sau.
Introspection (RFC 7662): cái bẫy "token của ai"
Khi MCP server nhận request kèm Bearer token, nó gọi introspection endpoint để hỏi authorization server: "token này còn sống không, của ai, quyền gì?"
POST /o/introspect HTTP/1.1
Content-Type: application/x-www-form-urlencoded
Authorization: Basic <client_credentials của MCP server>

token=<access_token>&token_type_hint=access_token
Token hết hạn không trả lỗi mà trả 200 OK với {"active": false} — đây là behavior chuẩn của RFC 7662 mà nhiều implementation làm sai.
Cái bẫy lớn nhất tôi gặp phải là câu hỏi "token có thuộc về client đang gọi introspect không?". Phản xạ đầu tiên là check:
# SAI về mặt logic
if token_info.client.client_id != caller.client_id:
    raise Exception('Token does not belong to the client')
Nhưng nhìn lại trust model: token được cấp cho Claude.ai (resource client), còn bên gọi introspect là MCP server (resource server). Hai client này khác nhau là điều đương nhiên — check như trên sẽ chặn mọi request hợp lệ.
Câu hỏi đúng phải là: "MCP server này có quyền introspect token này không?" Trả lời bằng cách so audience của token với resource_uri của server:
# 1. Bên gọi phải là resource server
if caller.client_type not in ['mcp_server', 'resource_server']:
    raise Exception('Client is not authorized to introspect tokens')

# 2. Audience của token phải khớp resource mà server bảo vệ
token_audience = token_info.authorization.resource
if token_audience and token_audience != caller.resource_uri:
    raise Exception('Token audience does not match the resource server')
Nhờ vậy, một MCP server không thể introspect (và do đó không thể dùng lén) token được cấp cho hệ thống khác — kể cả khi cả hai cùng dùng chung một identity server.
Revocation (RFC 7009): trả lời giống nhau cho mọi trường hợp
Revoke endpoint có một đặc điểm thiết kế thú vị: luôn trả 200 OK với body rỗng — bất kể token tồn tại, đã hết hạn, hay chưa từng tồn tại. Mục đích là chống token enumeration attack: kẻ tấn công không thể dùng response để dò xem token nào đang hoạt động.
def token_revocation(request):
    # validate client auth trước...
    token_value = request.POST.get('token')
    try:
        token_info = OAuthToken.objects.get(access_token=token_value)
        if not token_info.revoked:
            token_info.revoke(reason='User logout')
    except OAuthToken.DoesNotExist:
        pass  # RFC 7009: không báo lỗi nếu token không tồn tại
    return HttpResponse(status=200)  # body rỗng
Hai lỗi tôi từng mắc trong quá trình phát triển, chia sẻ để bạn đỡ giẫm lại:
- Endpoint trả
{"revoked": true}nhưng quên gọi hàm revoke thật — token vẫn sống, chỉ có response là dối. - Dùng chung hàm validate với introspect, khiến token không tồn tại bị raise exception → trả
400thay vì200, vi phạm spec và mở đường cho enumeration.
So sánh nhanh hai endpoint:
| Introspect (RFC 7662) | Revoke (RFC 7009) | |
|---|---|---|
| Token gửi qua | Body (token=) |
Body (token=) |
| Response | JSON có field active |
200 OK, body rỗng |
| Token hết hạn | 200 + {"active": false} |
200, không phân biệt |
| Mục tiêu thiết kế | Cho resource server hỏi trạng thái | Chống enumeration |
Shared Redis: revocation tức thì mà không hy sinh hiệu năng
Đây là phần tôi tâm đắc nhất. Có một mâu thuẫn kinh điển:
- JWT stateless verify offline rất nhanh, nhưng token đã revoke vẫn "sống" đến khi hết hạn.
- Introspect mọi request thì revoke có hiệu lực ngay, nhưng mỗi request tốn thêm một round-trip đến authorization server.
Giải pháp: authorization server (Django) và MCP server (Node.js) dùng chung một Redis làm introspection cache. Flow validate token trong middleware của MCP server gồm 4 bước:
1. Validate JWT local          — check format, expiry
2. Verify chữ ký qua JWKS      — offline, nhanh
3. Check Redis cache            — key: introspect:<token>
   ├─ active=false → reject ngay ("Token has been revoked")
   └─ active=true  → dùng authInfo đã cache, khỏi introspect
4. Gọi introspect (fallback)   — rồi cache kết quả với TTL ngắn
Điểm mấu chốt: khi Django xử lý revoke, nó ghi đè cache thành active: false trong cùng Redis đó. MCP server ở request kế tiếp đọc cache là thấy ngay — revocation có hiệu lực trong mili-giây, mà 99% request vẫn không phải gọi introspect.
Object được cache không chỉ có trạng thái mà cả thông tin phân quyền — user là ai, được phép truy vấn những bảng nào — nên đây đồng thời là cơ chế ánh xạ token → quyền dữ liệu per-user.
Redis chết thì sao? Fail-open hay fail-closed
Khi cache trở thành một mắt xích trong chuỗi xác thực, phải trả lời: Redis down thì hành xử thế nào?
| Fail-open (bỏ qua cache) | Fail-closed (trả 503) | |
|---|---|---|
| Redis down | Vẫn auth qua introspect trực tiếp | Từ chối phục vụ tạm thời |
| Token đã revoke | ⚠️ Có thể lọt qua | ✅ Chặn hoàn toàn |
| Trải nghiệm người dùng | Mượt hơn | Khắt khe hơn |
Tôi chọn fail-closed. Lý do: cơ chế revoke của tôi dựa vào việc Django ghi đè cache — nếu fail-open, đúng khoảng thời gian Redis down là lúc token đã revoke có thể đi qua. Với dữ liệu doanh nghiệp, tôi thà chịu 503 vài chục giây còn hơn để lọt một truy vấn từ token đã bị thu hồi.
Về mặt code, cần tách bạch lỗi hạ tầng khỏi lỗi token: định nghĩa RedisUnavailableError riêng, middleware bắt nó và trả 503 Service Unavailable thay vì 401 invalid_token — vì token không sai, hệ thống đang sự cố.
Circuit breaker cho reconnect
Một chi tiết nhỏ nhưng đáng giá: khi Redis down, đừng để mỗi request đều tốn timeout chờ connect. Tôi thêm circuit breaker đơn giản:
fail < 3 lần        → thử connect bình thường
fail >= 3 lần:
  trong 30s cooldown → throw ngay, không thử (circuit OPEN)
  hết cooldown       → reset, thử lại (HALF-OPEN)
connect thành công   → reset counter (CLOSED)
Và một lưu ý cho ai dùng node-redis: không cần connection pool. node-redis dùng một TCP connection với pipelining, các lệnh point lookup như GET/SETEX xử lý tốt trên single client. Pool chỉ cần khi dùng blocking commands (BLPOP, SUBSCRIBE) hoặc throughput cực cao đã đo được bottleneck ở tầng TCP. Thay vào đó, hãy đầu tư vào cấu hình socket:
createClient({
    url, username, password,
    database: parseInt(process.env.REDIS_DB || '0'),
    socket: {
        reconnectStrategy: (retries) => Math.min(retries * 100, 3000),
        keepAlive: 5000,
        connectTimeout: 5000,
    },
});
JWT và Redis: đừng nhầm cache với whitelist
Một anti-pattern tôi thấy nhiều người mắc: lưu toàn bộ JWT access token vào Redis làm whitelist, mỗi request tra Redis xem token có trong danh sách không. Cách này phá hỏng ý nghĩa stateless của JWT và biến Redis thành bottleneck — nhất là với hệ thống có hàng nghìn thiết bị IoT gửi request liên tục.
Nguyên tắc tôi áp dụng:
- Chỉ refresh token (opaque) mới lưu Redis, TTL dài.
- Access token sống ngắn (15 phút – 2 giờ tùy client), verify offline.
- Cần revoke khẩn cấp: blacklist theo
jti— chỉ ghi Redis khi revoke, validate chỉ check blacklist (thường rỗng, cực nhanh). - Với MCP server: introspection cache như trên — bản chất là blacklist thông minh có kèm thông tin phân quyền.
Kết nối với Claude.ai: những yêu cầu dễ vấp
Nếu bạn muốn MCP server của mình hoạt động như custom connector trên Claude.ai với per-user authentication, vài điểm từ tài liệu chính thức mà tôi đã vấp trong thực tế:
- Server phải trả
401kèm headerWWW-Authenticate: Bearer resource_metadata="..."— Claude không đọc header này trên response 200. - Metadata phải khai báo
code_challenge_methods_supported: ["S256"]— thiếu là Claude từ chối kết nối. - Field
resourcetrong protected resource metadata phải khớp chính xác URL MCP như người dùng nhập. - Endpoint
/tokenphải nhậnContent-Type: application/x-www-form-urlencoded. - Claude chờ tối đa 10 giây cho các endpoint discovery/registration/token.
- Tuyệt đối không nhúng credential vào URL hay query string — spec MCP cấm vì dễ leak qua log/proxy.
Kiểm chứng: revoke thật, xem chuyện gì xảy ra
Cách test tôi thấy hiệu quả nhất là làm thật trên môi trường đang chạy: revoke token của connector rồi quan sát.
Kết quả với hệ thống hoàn chỉnh: request đầu tiên sau revoke nhận 401 (middleware đọc cache thấy active: false), Claude host tự động chạy lại OAuth flow — refresh token hoặc PKCE flow đầy đủ — lấy token mới và retry thành công. Toàn bộ diễn ra trong suốt với người dùng.
Một edge case đáng ghi nhớ: nếu disable cả client app (chứ không chỉ revoke token), re-authorization không thể hoàn thành và connector biến mất im lặng khỏi danh sách tool — rất khó debug. Bài học: log lại các bước DCR fail ở phía server để có dấu vết.
Đã làm được gì — và thách thức còn lại
Đến thời điểm này, giải pháp đã vận hành thực tế với những kết quả kiểm chứng được:
- Người dùng phân tích dữ liệu bằng ngôn ngữ tự nhiên trên các data mart đã kiểm duyệt — doanh thu, khách hàng, sản phẩm, KPI — AI tự sinh SQL và trả về báo cáo có cấu trúc.
- Mỗi truy vấn gắn với một danh tính cụ thể: token mang theo thông tin user và danh sách bảng được phép, MCP server kiểm tra trước khi thực thi.
- Thu hồi quyền có hiệu lực trong mili-giây qua shared cache, đã test thật bằng cách revoke token trên hệ thống đang chạy.
- Chuẩn hóa theo RFC (7662, 7009, 7591, 8707) nên tương thích với mọi MCP client tuân thủ spec, không khóa chặt vào một AI provider.
Nhưng tôi không muốn vẽ bức tranh màu hồng. Những thách thức đang đối mặt:
Phân quyền là bài toán tổ chức, không chỉ kỹ thuật. Token mang được allowedTables, nhưng ai quyết định user nào thấy bảng nào? Ánh xạ từ sơ đồ tổ chức — phòng ban, cấp bậc, kiêm nhiệm, luân chuyển — sang scope OAuth là công việc liên tục cần sự tham gia của cả quản trị dữ liệu lẫn nhân sự, và mô hình đó thay đổi thường xuyên hơn code.
Chất lượng phân tích phụ thuộc vào context nghiệp vụ. AI sinh SQL đúng cú pháp thì dễ, nhưng hiểu "doanh thu thuần" tính theo cột nào, kỳ kế toán bắt đầu từ đâu, đơn vị nào là tấn đơn vị nào là kg — đòi hỏi tài liệu ngữ nghĩa (semantic layer) đi kèm mỗi bảng, được nạp vào context theo session. Duy trì tài liệu này đồng bộ với DWH đang tiến hóa là chi phí thường trực, và mỗi lần thiếu sót là một lần AI trả lời sai một cách tự tin.
Whitelist có giá của nó. Mỗi nhu cầu phân tích mới đồng nghĩa với việc xây một data mart tổng hợp trước khi expose — an toàn hơn nhưng chậm hơn so với mở thẳng bảng giao dịch. Cân bằng giữa tốc độ đáp ứng nghiệp vụ và kỷ luật kiểm duyệt là giằng co không có điểm dừng.
Observability còn mỏng. Sự cố khó chịu nhất tôi gặp là connector "biến mất im lặng" phía client khi luồng re-authorization thất bại — không lỗi rõ ràng, không thông báo. Audit log đầy đủ cho cả chuỗi (DCR, cấp token, introspect, revoke, từng câu SQL) là thứ phải đầu tư tiếp nếu muốn hệ thống này đứng được trước một cuộc kiểm toán.
Tokenization chưa phải lời giải trọn vẹn cho dữ liệu nhạy cảm — như phân tích ở phần sau, nó đánh đổi ngữ nghĩa của dữ liệu, và ranh giới trường nào tokenize, trường nào giữ nguyên vẫn phải quyết định thủ công theo từng bài toán.
Lộ trình triển khai: từ cloud đến tự chủ hoàn toàn
Không phải tổ chức nào cũng cần cùng một mức độ kiểm soát. Tôi hình dung lộ trình triển khai MCP data analysis theo bốn cấp độ, tăng dần theo độ nhạy cảm của dữ liệu và yêu cầu pháp lý:
| Cấp độ | Deploy | MCP Client | Đặc điểm |
|---|---|---|---|
| 1 — Khởi đầu | Cloud, hạ tầng dùng chung | claude.ai | MCP server deploy trên cloud, phù hợp cá nhân/nhóm nhỏ thử nghiệm |
| 2 — Doanh nghiệp | MCP + Auth Server cài riêng | claude.ai | Không ràng buộc luật dữ liệu đặc thù, kết nối thẳng DWH sẵn có, phân quyền per-user như các phần trên |
| 3 — Dữ liệu nhạy cảm | On-premise | claude.ai | Dữ liệu được tokenize/detokenize tại MCP server trước khi giao tiếp với AI — dữ liệu thật không rời môi trường |
| 4 — Tự chủ hoàn toàn | On-premise toàn bộ | Business server / chat client tự xây | Web/Mobile app riêng, MCP client riêng, gọi LLM qua API key, tokenize/detokenize ở tầng gọi LLM |
Cấp 1 và 2 chính là những gì bài viết đã trình bày: whitelist + OAuth 2.1 + shared cache. Cấp 3 và 4 bổ sung một kỹ thuật nữa đáng nói riêng.
Tokenize/Detokenize: khi dữ liệu thật không được rời môi trường
Với các tổ chức chịu ràng buộc pháp lý về dữ liệu (khối nhà nước, tài chính, y tế), OAuth chỉ giải quyết được câu hỏi "ai được truy vấn" — nhưng bản thân nội dung trả về vẫn đi qua LLM bên ngoài. Tên khách hàng, mã số thuế, số tiền hợp đồng nằm trong prompt và response gửi lên cloud là điều không chấp nhận được.
Kỹ thuật xử lý là tokenization ngay tại MCP server, đóng vai trò như một lớp màng lọc hai chiều:
DWH → MCP Server ──[tokenize]──→ LLM (cloud)
                                    │
Người dùng ←──[detokenize]── MCP Server ←── response
- Chiều đi (tokenize): trước khi kết quả truy vấn rời MCP server, các giá trị nhạy cảm được thay bằng token vô nghĩa —
"Công ty TNHH ABC"thành"CUST_7f3a", số tiền thật thành token số giữ nguyên quan hệ thứ tự nếu cần so sánh. Bảng ánh xạ token ↔ giá trị thật chỉ tồn tại trong môi trường on-premise (Redis hoặc DB nội bộ, có TTL theo session). - Chiều về (detokenize): LLM phân tích và trả lời trên token — nó vẫn tính toán, so sánh, xếp hạng được vì cấu trúc dữ liệu còn nguyên. MCP server nhận response, tra bảng ánh xạ và thay token ngược lại thành giá trị thật trước khi hiển thị cho người dùng.
Điều thú vị là LLM làm việc với dữ liệu đã tokenize gần như không suy giảm chất lượng phân tích với các bài toán tổng hợp, so sánh, xếp hạng — vì nó chỉ cần quan hệ giữa các giá trị chứ không cần biết giá trị thật là gì. Đánh đổi nằm ở các câu hỏi cần ngữ nghĩa của chính giá trị (ví dụ "khách hàng nào thuộc ngành xây dựng" khi ngành nghề đã bị tokenize) — những trường đó cần cân nhắc để nguyên hoặc tokenize theo nhóm.
Ở cấp độ 4, tổ chức tự xây cả chat client, vị trí tokenize dịch lên tầng gọi LLM API — nguyên lý không đổi, chỉ khác điểm đặt màng lọc. Toàn bộ trải nghiệm người dùng, MCP client, và bảng ánh xạ đều nằm trong hạ tầng tự chủ; LLM bên ngoài chỉ thấy token.
Kết
MCP đã hạ rào cản kỹ thuật xuống rất thấp — server chạy được không còn là thành tựu. Thứ tạo nên một giải pháp là những tầng bao quanh: whitelist dữ liệu ở tầng thấp nhất, OAuth 2.1 với introspect/revoke đúng spec ở tầng xác thực, shared cache để dung hòa hiệu năng với thu hồi quyền tức thì, và tokenize/detokenize khi dữ liệu thật không được rời môi trường. Không tầng nào thay thế được tầng nào — và như phần thách thức đã nói, ngay cả đủ bốn tầng thì phân quyền, semantic layer và observability vẫn là công việc không có ngày kết thúc.
Nếu bạn đang ở giai đoạn PoC với nhóm nhỏ tin cậy nhau, một endpoint authless sau VPN là đủ — đừng over-engineer. Nhưng thời điểm dữ liệu nhạy cảm bắt đầu đi qua MCP, hoặc số người dùng vượt quá một team, thì introspection với audience check và revocation tức thì không còn là "nice to have". Kinh nghiệm của tôi: xây identity server đúng spec ngay từ đầu tốn khoảng vài ngày, còn retrofit bảo mật vào hệ thống đã chạy tốn gấp nhiều lần — kèm theo những đêm mất ngủ tự hỏi token cũ nào còn đang trôi nổi ngoài kia.