JSON-RPC 2.0 Server Framework with Kotlin/Java and Apache Tomcat
· cập nhật 13/08/2026
Gần 20 năm qua tôi phát triển và mang theo một framework JSON-RPC của riêng mình qua nhiều dự án, nhiều thế hệ công nghệ — chạy trên Apache Tomcat thuần với servlet API, và chưa bao giờ cần đến Spring. Hôm nay nó đang vận hành hai hệ thống production ở hai domain hoàn toàn khác nhau — giám sát IoT thời gian thực và quản lý xuất nhập kho — trên cùng một core, và core đó gần như không phải sửa gì khi triển khai sang bài toán mới. Bài viết này kể lại triết lý thiết kế đằng sau nó, những trade-off tôi chấp nhận, và vì sao trong kỷ nguyên AI-assisted development, cách tiếp cận "explicit over abstract" lại càng đúng hơn.
Hai mươi năm, ba thế hệ
Framework này không sinh ra trong một buổi chiều. Nó bắt nguồn từ khi tôi mới đi làm và tiếp xúc với các dự án billing thời Java Applet + Servlet — những hệ thống phục vụ hàng triệu khách hàng, nơi tôi học được thế nào là code phải đứng vững dưới tải thật và cái giá của một lỗi lọt đến production. Khi Applet lỗi thời, thay vì vá víu, tôi thiết kế lại từ đầu vào khoảng năm 2012, lần này phục vụ các ứng dụng Android từ những ngày sơ khai của nền tảng — và mô hình JSON-RPC của framework ra đời từ chính nhu cầu đó: client di động cần một RPC protocol đơn giản, ổn định và phù hợp với mô hình gọi method nghiệp vụ.
Phiên bản mới nhất tôi đang phát triển đã được convert hoàn toàn sang Kotlin, nhưng vẫn tương thích trọn vẹn với Java — code Java cũ gọi vào, handler Java mới viết thêm, đều chạy bình thường. Trong quá trình đó, những module Java lỗi thời hoặc không còn đáp ứng yêu cầu bảo mật bị loại bỏ thẳng tay; framework hiện chạy trên JDK 21 trở lên.
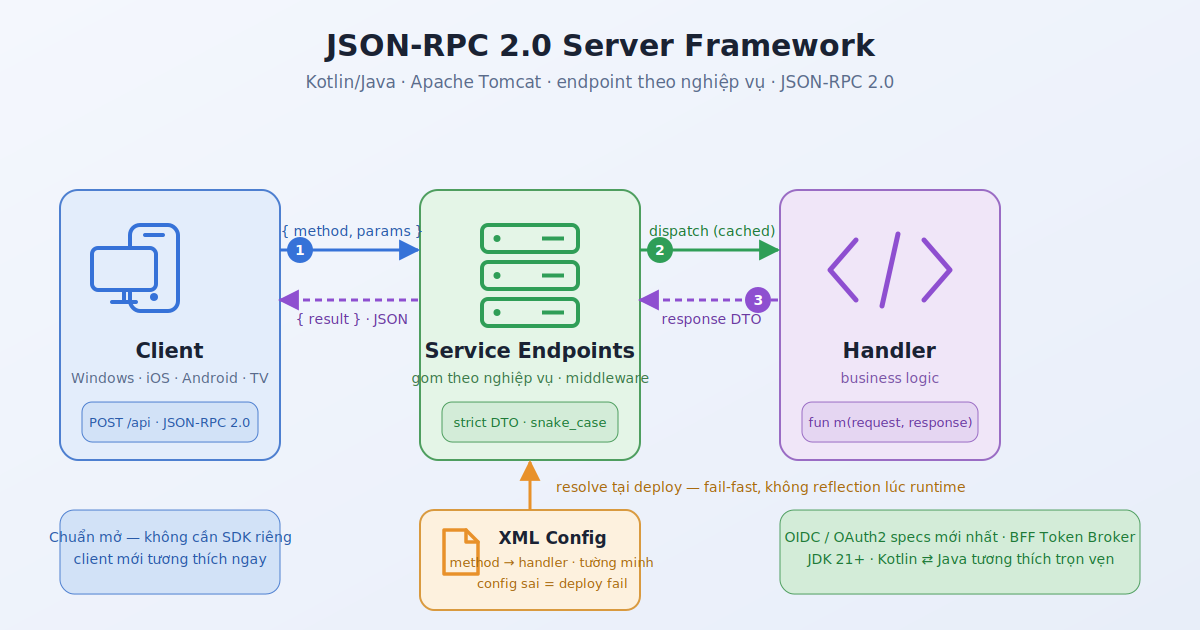
Ở phía client, framework hiện phục vụ đủ các nền tảng: Windows, iOS, Android mobile và Android TV. Không cần SDK riêng cho từng nền tảng — vì bản chất framework tuân thủ nghiêm ngặt chuẩn JSON-RPC 2.0, bất kỳ client nào nói được JSON-RPC 2.0 qua HTTP đều tích hợp được. Đây là lợi ích ít được nhắc đến của việc bám chuẩn mở thay vì tự chế giao thức: chuẩn đã định nghĩa sẵn contract, mọi nền tảng mới xuất hiện đều tương thích từ ngày đầu.
Ba thế hệ công nghệ — Applet/Servlet, Android/Java, Kotlin/JDK 21 — nhưng triết lý thiết kế thì không đổi. Đó không phải sự trì trệ; đó là những nguyên tắc đã được kiểm chứng đủ lâu để tôi tin chúng đúng.
Vì sao không Spring?
Câu hỏi tôi nhận được nhiều nhất khi ai đó đọc code của tôi: "Sao không dùng Spring cho nhanh?"
Câu trả lời ngắn: vì tôi chưa thấy nó cần thiết ở đâu cả. Câu trả lời dài hơn: Spring ở đây chỉ là điểm tham chiếu quen thuộc để nói về trade-off — những bài toán Spring giải quyết, tôi giải quyết theo cách khác, đơn giản hơn và dễ kiểm soát hơn với phạm vi của mình:
- DI container → tôi không cần. Toàn bộ wiring khai báo tường minh trong file cấu hình XML và được resolve bằng reflection tại thời điểm deploy. Config sai là deploy fail ngay, kèm thông báo lỗi chỉ đích danh method nào, class nào — thay vì một stack trace 200 dòng của Spring context lúc runtime.
@Transactional→ framework có transaction management ở tầng middleware: khai báo trong config là endpoint được cấp connection từ pool, tự đóng, tự commit khi handler thành công và rollback khi có lỗi — cần kiểm soát manual cũng chỉ là một lựa chọn config. Vì transaction được thực hiện trực tiếp ở middleware thay vì thông qua proxy interception, framework không phụ thuộc vào các semantics đặc thù của proxy — như hành vi self-invocation hay rule mặc định về rollback của Spring.- Spring MVC routing → framework của tôi theo mô hình JSON-RPC: endpoint gom theo nhóm nghiệp vụ, trong mỗi endpoint routing theo tên method; các logic xuyên suốt — xác thực, validate, logging — đi qua tầng middleware nên vẫn đảm bảo nhất quán mà không cần một tầng MVC đầy đủ.
- Spring Security → tầng bảo mật của framework được xây dựng trực tiếp theo spec: hiện implement các flow OIDC/OAuth2 cần thiết cho hệ thống — Authorization Code, refresh token với token rotation, và Back-Channel Logout — implement sát nghiệp vụ thay vì đi qua filter chain generic. Với native apps, framework còn đóng vai trò BFF / Token Broker — token không bao giờ nằm phía client mà được backend giữ và điều phối, mô hình tôi đã phân tích chi tiết trong bài Tăng cường bảo mật OAuth flow với Backend-Brokered SSO cho native apps. Nhét một luồng xác thực custom vào Spring Security nghĩa là dành phần lớn thời gian "đánh nhau" với abstraction thay vì được nó giúp; tự implement theo spec thì mỗi dòng code bảo mật đều là thứ tôi đọc hiểu và audit được.
Mỗi thư viện trong stack làm đúng một việc: Jackson lo serialization, HikariCP lo connection pool, servlet API lo HTTP. Không có tầng magic nào ở giữa. Khi có bug, tôi trace được từ servlet → resolve → handler bằng cách đọc code tuần tự.
Kiến trúc: ba thứ cần hiểu, không hơn
Toàn bộ "contract" của framework nằm trong tầm mắt. Một dev mới chỉ cần nắm ba thứ:
1. Khai báo method trong file cấu hình XML. Mỗi API method được khai báo tường minh: tên method và class handler. Không có classpath scanning, không có annotation processing chạy ngầm. DTO request/response không cần khai trong config — middleware tự resolve kiểu từ chính handler signature và ép kiểu payload vào đó, nên sai kiểu là chết ngay ở tầng middleware, không lọt vào business logic.
Nghe đến "XML config" nhiều người sẽ nghĩ ngay đến những file cấu hình Spring dài hàng trăm dòng với bean wiring chằng chịt — ở đây thì ngược lại: file config chỉ là một danh sách khai báo phẳng, mỗi method vài dòng, đọc lướt là nắm được toàn bộ API surface. Một service thực tế trông như thế này:
<service name="AuthorizationService" class="api.example.service.AuthorizationService">
    <method name="device_registration" login_require="false"/>
    <method name="login" login_require="false"/>
</service>
Ba dòng — bạn có một endpoint với hai method, và ngay cả yêu cầu xác thực cũng nằm tường minh trong khai báo (login_require): middleware đọc attribute này để quyết định có chặn request chưa đăng nhập hay không, không cần annotation hay filter chain nào ở giữa. Và vì file config chỉ làm đúng một việc là chứa khai báo, XML không phải một quyết định kiến trúc — thay bằng JSON hay format khác cũng không ảnh hưởng gì đến framework; thứ quan trọng là sự khai báo tường minh, không phải định dạng file.
2. Handler theo convention hai tham số.
fun methodName(request: SomeRequest, response: SomeResponse) {
    // business logic
}
Không kế thừa base class nào, không annotation nào. Framework chỉ thực hiện việc resolve handler bằng reflection một lần trong quá trình khởi tạo và cache kết quả — runtime không thực hiện lại quá trình type/method resolution.
3. DTO strict. JSON snake_case, FAIL_ON_UNKNOWN_PROPERTIES bật — client gửi field lạ là lỗi ngay tại tầng DTO, không lọt sâu vào business logic rồi mới vỡ.
Hết. Không có phần bốn.
Triết lý: explicit over abstract, fail-fast everywhere
Hai nguyên tắc này xuyên suốt framework từ những phiên bản đầu tiên:
Explicit over abstract. Tôi từng thử con đường generic base class, abstraction tầng tầng lớp lớp — và quay đầu. Reflection-based type resolution vỡ với generic base class do type erasure; nhưng lý do sâu hơn là chi phí đọc hiểu. Code lặp lại một chút nhưng ai đọc cũng hiểu ngay, đắt hơn hay rẻ hơn một abstraction "thông minh" mà mỗi lần debug phải dựng lại mô hình trong đầu? Sau 20 năm, câu trả lời của tôi rất rõ ràng.
Fail-fast at deploy. Mọi lỗi cấu hình phải làm deploy fail ngay lập tức, với thông báo lỗi mà một junior developer đọc là biết sửa ở đâu. Lỗi xuất hiện đồng thời trong log của server và Output tab của IDE — vì người trực hệ thống không phải lúc nào cũng là người viết ra nó.
Kỷ nguyên AI làm thay đổi phép tính
Lập luận kinh điển bảo vệ framework lớn: "đừng reinvent the wheel, code lặp lại là lãng phí". Lập luận này đang yếu đi nhanh chóng.
Với AI-assisted development, chi phí viết code lặp lại gần như bằng không — đưa 1-2 handler mẫu vào context, AI có thể sinh handler mới với độ chính xác rất cao, vì pattern hoàn toàn cục bộ và contract rõ ràng, không phụ thuộc trạng thái ẩn nào. Ngược lại, chi phí duy trì abstraction phức tạp vẫn nguyên đó, thậm chí tăng lên: AI phải "đoán" hành vi của framework — version nào, starter nào đang bật, annotation nào override annotation nào — và đó chính là chỗ sinh hallucination nhiều nhất. Explicit local pattern dễ suy luận hơn abstraction có hidden state — điều này đúng với AI, và cũng đúng với con người.
Có một chi phí rất cụ thể mà tôi nhận thấy rõ khi dùng các AI coding agent — Cursor, GitHub Copilot hay Claude — viết code trên một framework lớn: context window. Trước khi AI viết được dòng code hữu ích đầu tiên, tôi phải "nạp" cho nó cả bối cảnh hệ sinh thái — project dùng thư viện nào, annotation ở version mấy, config nằm ở đâu, starter nào đang bật — và phần lớn token của cuộc hội thoại bị đốt vào việc mô tả framework thay vì mô tả vấn đề cần giải.
Thực tế sử dụng của tôi xác nhận điều ngược lại cũng đúng: để AI coding agent làm việc với framework này, tôi chỉ cần vài dòng mô tả convention — handler hai tham số, khai báo trong XML, DTO strict — là agent đã tự thêm được chức năng mới đúng pattern. Toàn bộ context window còn lại dành trọn cho việc mô tả business logic — đúng chỗ mà thời gian của con người và token của AI đáng giá nhất.
Onboard một junior vào framework của tôi là học một codebase. Onboard vào Spring là học một hệ sinh thái trước, rồi mới đến codebase.
Điều kiện duy nhất để giữ được lợi thế này: phần core phải nhỏ, ổn định và gần như đóng băng. Core được test kỹ, ít người động vào; còn bề mặt mở rộng — handlers, DTOs — thì rộng, lặp pattern, ai thêm vào cũng an toàn. Đó là cấu trúc lý tưởng để scale cả team người lẫn AI.
Trade-off tôi chấp nhận
Không có lựa chọn nào miễn phí. Đổi lại sự tường minh, tôi chấp nhận:
- Code lặp lại nhiều hơn so với dùng abstraction — nhưng phần code lặp này nằm ở tầng mở rộng gắn trực tiếp với nghiệp vụ, nơi sự tường minh đáng giá hơn hết: mỗi handler tự đứng độc lập, đọc là hiểu, sửa không sợ ảnh hưởng dây chuyền. Với business code, dễ bảo trì quan trọng hơn ngắn gọn — và chi phí viết phần lặp này, như đã nói, ngày càng rẻ.
- Không có hệ sinh thái starter đại trà: Spring có sẵn starter cho mọi công nghệ phổ biến, còn với framework của tôi, mỗi tích hợp mới là tự tay wire. Nhưng đây là lựa chọn phạm vi chứ không phải giới hạn kiến trúc — những module dùng lặp lại qua nhiều dự án, như tầng OIDC/OAuth2, đều được đóng gói tái sử dụng theo đúng tinh thần starter: thêm dependency, khai config là chạy. Khác ở chỗ tôi chỉ đóng gói những gì mình thực sự cần, thay vì gánh một hệ sinh thái phục vụ mọi use case của người khác.
- Tự dựng khung integration test thay vì có sẵn
@SpringBootTest— đổi lại, test chạy trên đúng những gì production chạy, không qua context giả lập. - Không có cộng đồng đứng sau: mọi câu hỏi về framework, người trả lời là tôi. Bù lại, câu trả lời luôn chính xác, vì không có version drift giữa tài liệu và code.
Framework này đang chạy ở đâu?
Hai hệ thống production đang vận hành trên framework, ở hai bài toán rất khác nhau:
Hệ thống giám sát IoT thời gian thực — theo dõi hơn 2.000 thiết bị IoT trong môi trường công nghiệp, dữ liệu đổ về liên tục 24/7. Ở quy mô này, framework đóng vai trò API backbone: mọi cấu hình sai phải chết ở deploy chứ không được lọt đến runtime, vì một lỗi lọt lưới đồng nghĩa với mất dữ liệu giám sát.
Hệ thống quản lý xuất nhập kho — phục vụ 3 nhà máy, mỗi nhà máy khoảng 200 công nhân hoạt động liên tục. Đây là hệ thống mission-critical đúng nghĩa: downtime không phải là một ticket bug, mà là dây chuyền xuất nhập đứng lại và 600 con người phải chờ. Triết lý fail-fast-at-deploy tồn tại trong framework từ đầu chính là vì những môi trường như thế này.
Hai case, hai domain, cùng một core — và core đó gần như không phải sửa gì khi triển khai sang bài toán mới. Đó là phép thử tốt nhất cho một thiết kế: không phải nó làm được gì trong demo, mà nó đứng vững thế nào sau nhiều năm production.
Kết
Tôi không viết bài này để khuyên bạn bỏ Spring — mà để nói rằng Spring không phải mặc định bắt buộc. Những gì Spring cho — convention thống nhất, khả năng mở rộng, xử lý transaction, bảo mật — framework của tôi đều đáp ứng trong phạm vi bài toán của mình, chỉ là theo cách tường minh thay vì qua các tầng abstraction. Convention của tôi nằm trong file cấu hình và handler signature mà ai đọc cũng thấy; transaction và bảo mật được thiết kế sát nghiệp vụ thay vì đi qua lớp generic của người khác.
Khác biệt thật sự không nằm ở năng lực, mà ở đối tượng phục vụ và quyền kiểm soát. Spring phục vụ developer bằng cả một hệ sinh thái — càng dùng sâu, bạn càng giỏi Spring. Framework của tôi phục vụ bài toán nghiệp vụ: mục tiêu là business được thể hiện tường minh đến mức bất kỳ ai nắm kiến thức codebase — junior, dev mới vào, hay AI — đều đọc hiểu và đóng góp được ngay, không cần qua một hệ tri thức trung gian nào. Và về quyền kiểm soát: với Spring, bạn vay năng lực của hệ sinh thái và trả lãi bằng sự phụ thuộc — vào release cycle, vào breaking change, vào những quyết định thiết kế không phải của bạn. Với framework tự chủ, mọi dòng code định hình hành vi hệ thống đều là thứ bạn hiểu và thay đổi được.
Framework của tôi đã sống 20 năm qua ba thế hệ công nghệ không phải vì may mắn, mà vì các nguyên tắc của nó — explicit, fail-fast, core ổn định — đúng từ thời Applet, đúng với Android, đúng với Kotlin trên JDK 21, và trong kỷ nguyên AI-assisted development, lại càng đúng hơn bao giờ hết.