Phát hiện bất thường tại đường ngang bằng One-Class SVM
· cập nhật 07/08/2026
Bối cảnh
Việt Nam có khoảng 10.000 đường ngang trên toàn mạng lưới đường sắt, và con số vẫn tăng theo hạ tầng. Mỗi đường ngang được trang bị một cụm thiết bị an toàn: sáu cảm biến từ dọc theo ray (hai cái đặt trước 1–5 km để phát hiện tàu sớm, hai cái tại giao lộ để xác nhận tàu đang qua), cần chắn, đèn tín hiệu, chuông, nguồn AC/DC dự phòng — tất cả nối về PLC và đẩy dữ liệu qua 3G/4G về trung tâm.
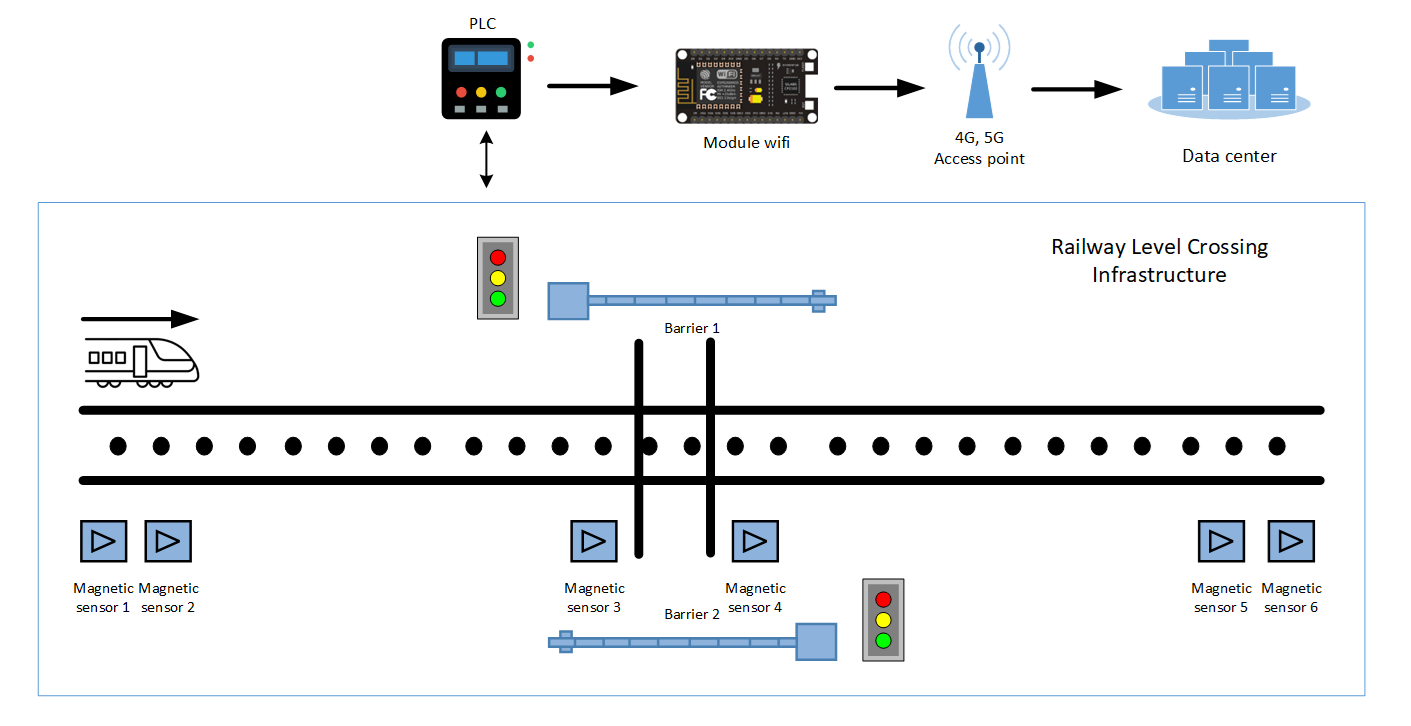
Vấn đề không nằm ở thu thập dữ liệu — dữ liệu đã về trung tâm đầy đủ. Vấn đề là dữ liệu chỉ được hiển thị, còn quyết định vẫn do con người: một trung tâm giám sát chịu trách nhiệm cho hàng nghìn điểm, mỗi điểm phát hơn 40 tham số liên tục. Tải nhận thức đó dẫn thẳng đến phản ứng chậm và rủi ro bỏ sót.
Có một lý do sâu hơn khiến bài toán này không giải được bằng rule engine hay supervised learning: phần lớn kịch bản nguy hiểm chưa từng xảy ra. Không có nhãn để học. Tổ hợp của 40+ tham số tạo ra một không gian anomaly khổng lồ mà không ai liệt kê trước được — trong khi chỉ cần cần chắn đóng chậm vài giây so với chuỗi tín hiệu là đã thành rủi ro thật.
Đây là bài toán tôi và cộng sự giải trong một nghiên cứu về phát hiện bất thường tại đường ngang bằng unsupervised learning, trên dữ liệu IoT thật của mạng lưới đường sắt Việt Nam. Bài này tóm tắt cách tiếp cận và những bài học kỹ thuật đáng chia sẻ nhất.
Vì sao One-Class SVM
Logic đảo ngược của bài toán quyết định lựa chọn mô hình: thay vì học "bất thường trông như thế nào" (không có dữ liệu), ta học "bình thường trông như thế nào" — thứ có hàng nghìn sự kiện tàu qua mỗi ngày để học. Mọi thứ lệch khỏi biên đó đều đáng để operator nhìn vào.
One-Class SVM làm đúng việc này: dựng một decision boundary bao quanh vùng hành vi chuẩn trong không gian đặc trưng, kernel RBF để bắt quan hệ phi tuyến giữa các cảm biến, cặp siêu tham số (ν, γ) điều khiển cân bằng giữa độ nhạy và tỉ lệ báo động giả. Điểm hợp nữa với ngữ cảnh đường sắt: OCSVM nhẹ, chạy được mà không đòi hạ tầng GPU — điều quan trọng với hệ thống hạ tầng ở quy mô quốc gia nhưng ngân sách tính toán thực tế.
Pipeline
Phần thú vị nhất: feature engineering theo domain
Mô hình chỉ tốt bằng đặc trưng nó nhìn thấy, và với dữ liệu cảm biến vật lý, đặc trưng tốt đến từ hiểu biết vận hành chứ không phải từ thuật toán. Bốn kỹ thuật chính:
Min-max scale có ngưỡng. Cảm biến từ đếm xung khi trục bánh tàu đi qua — giá trị tăng dần theo thời gian, đỉnh thì ổn định. Chuẩn hóa quanh ngưỡng phát hiện tàu (thay vì min tuyệt đối) giữ được ngữ nghĩa "có tàu / không có tàu" trong đặc trưng.
Peak Difference Analysis. Các cảm biến từ được lắp thành cặp kế tiếp để dự phòng lẫn nhau — nghĩa là hai chuỗi giá trị tương quan chặt. So lệch đỉnh giữa cặp cảm biến chia cho khoảng thời gian giữa hai đỉnh làm nổi bật những sai lệch đột ngột mà mô hình nhìn giá trị thô sẽ bỏ qua — đặc biệt hữu ích với bất thường về tốc độ tàu không đều.
Đặc trưng thời gian. Quan hệ đáng giá nhất trong dữ liệu này là quan hệ trình tự: tàu vào vùng phát hiện → tín hiệu đóng chắn → chắn đóng hoàn toàn. Khoảng Δt từ lúc phát tín hiệu đến lúc chắn đóng xong đi thẳng vào feature vector — vì đó chính là con số quyết định an toàn.
Z-score theo pha. Thay vì chuẩn hóa cả sự kiện như một khối, z-score được tính riêng cho từng pha: tàu đang đến, đang qua, đã rời. Cùng một giá trị cảm biến có thể bình thường ở pha này và bất thường ở pha khác — gộp chung sẽ pha loãng tín hiệu.
Ví dụ cụ thể cho thấy sức mạnh của cách tiếp cận: z-score của thời gian đóng chắn qua nhiều sự kiện cho phép phát hiện suy hao cơ khí của hệ thống chắn trước khi nó hỏng hẳn — chắn đóng chậm dần từng ngày là thứ mắt người không nhận ra trên dashboard, nhưng nổi rất rõ trên phân phối thống kê.
Đánh giá
Thách thức kinh điển của unsupervised anomaly detection: đánh giá bằng gì khi không có nhãn? Cách làm trong nghiên cứu: train trên dữ liệu vận hành bình thường từ nhiều đường ngang, sinh tập anomaly tổng hợp với tỉ lệ xuất hiện thay đổi để đo khả năng phát hiện, đánh giá bằng precision/recall/F1/AUC-ROC, và chạy phân tích độ nhạy siêu tham số để kiểm tra tính ổn định. Kết quả đạt 96% accuracy trên dữ liệu thật của mạng lưới — đủ để hệ thống chuyển vai trò từ "màn hình hiển thị" sang "bộ lọc chú ý": operator không còn phải nhìn nghìn điểm, chỉ nhìn những điểm mô hình đã khoanh.
Bài học mang về từ nghiên cứu
- Bài toán quyết định paradigm, không phải ngược lại. Không gian anomaly không thể gán nhãn trước → supervised bị loại ngay từ đề bài, không phải vì mô hình nào "xịn" hơn.
- Domain knowledge ăn đứt model complexity. Toàn bộ giá trị của pipeline nằm ở những đặc trưng như Δt đóng chắn hay lệch đỉnh cặp cảm biến — những thứ chỉ nghĩ ra được khi hiểu cái đường ngang vận hành thế nào. Mô hình phía sau là OCSVM cổ điển.
- Anomaly detection là bài toán giảm tải nhận thức. Đích đến thực sự không phải con số accuracy, mà là đổi vai trò con người: từ phải nhìn tất cả sang chỉ nhìn nơi đáng nhìn.
Nghiên cứu này cũng là mảnh ghép trong hướng lớn hơn tôi đang theo đuổi — đưa dữ liệu IoT công nghiệp qua các lớp xử lý thông minh (thống kê, ML, và gần đây là LLM qua MCP) để hỗ trợ ra quyết định. Sẽ còn các bài tiếp theo về những tầng phía trên của stack này.
Bài báo đầy đủ: Ngo Anh Tuan, Nguyen Nhu Hai Linh, Pham Van Hiep, Vu Thu Diep, Phan Duy Hung — "Anomaly Detection for Vietnam Railway Using Unsupervised Learning Based on IoT Device Data Monitoring Railway Level Crossings", ICCSA 2025 Workshops, LNCS vol. 15886, Springer. DOI: 10.1007/978-3-031-97576-9_1
Bộ dữ liệu cảm biến đường ngang dùng trong nghiên cứu đã được công khai trên Kaggle.